2026年10月17日至18日,中央民族大学国家语言资源监测与研究民族语言中心赵小兵教授、孙媛教授、陈波副教授、孙京博讲师、高歌讲师带领中心12位硕、博士生参加了本次在湖北宜昌举行的第二十五届中国计算语言学大会(CCL 2026)。
中国计算语言学大会(CCL)是国内计算语言学与中文信息处理领域具有重要影响力的学术会议,旨在促进计算语言学、自然语言处理及相关领域的学术交流与技术创新。本届大会汇聚了来自全国高校、科研院所及相关企业的专家学者,围绕大语言模型、自然语言理解等前沿方向展开深入交流。
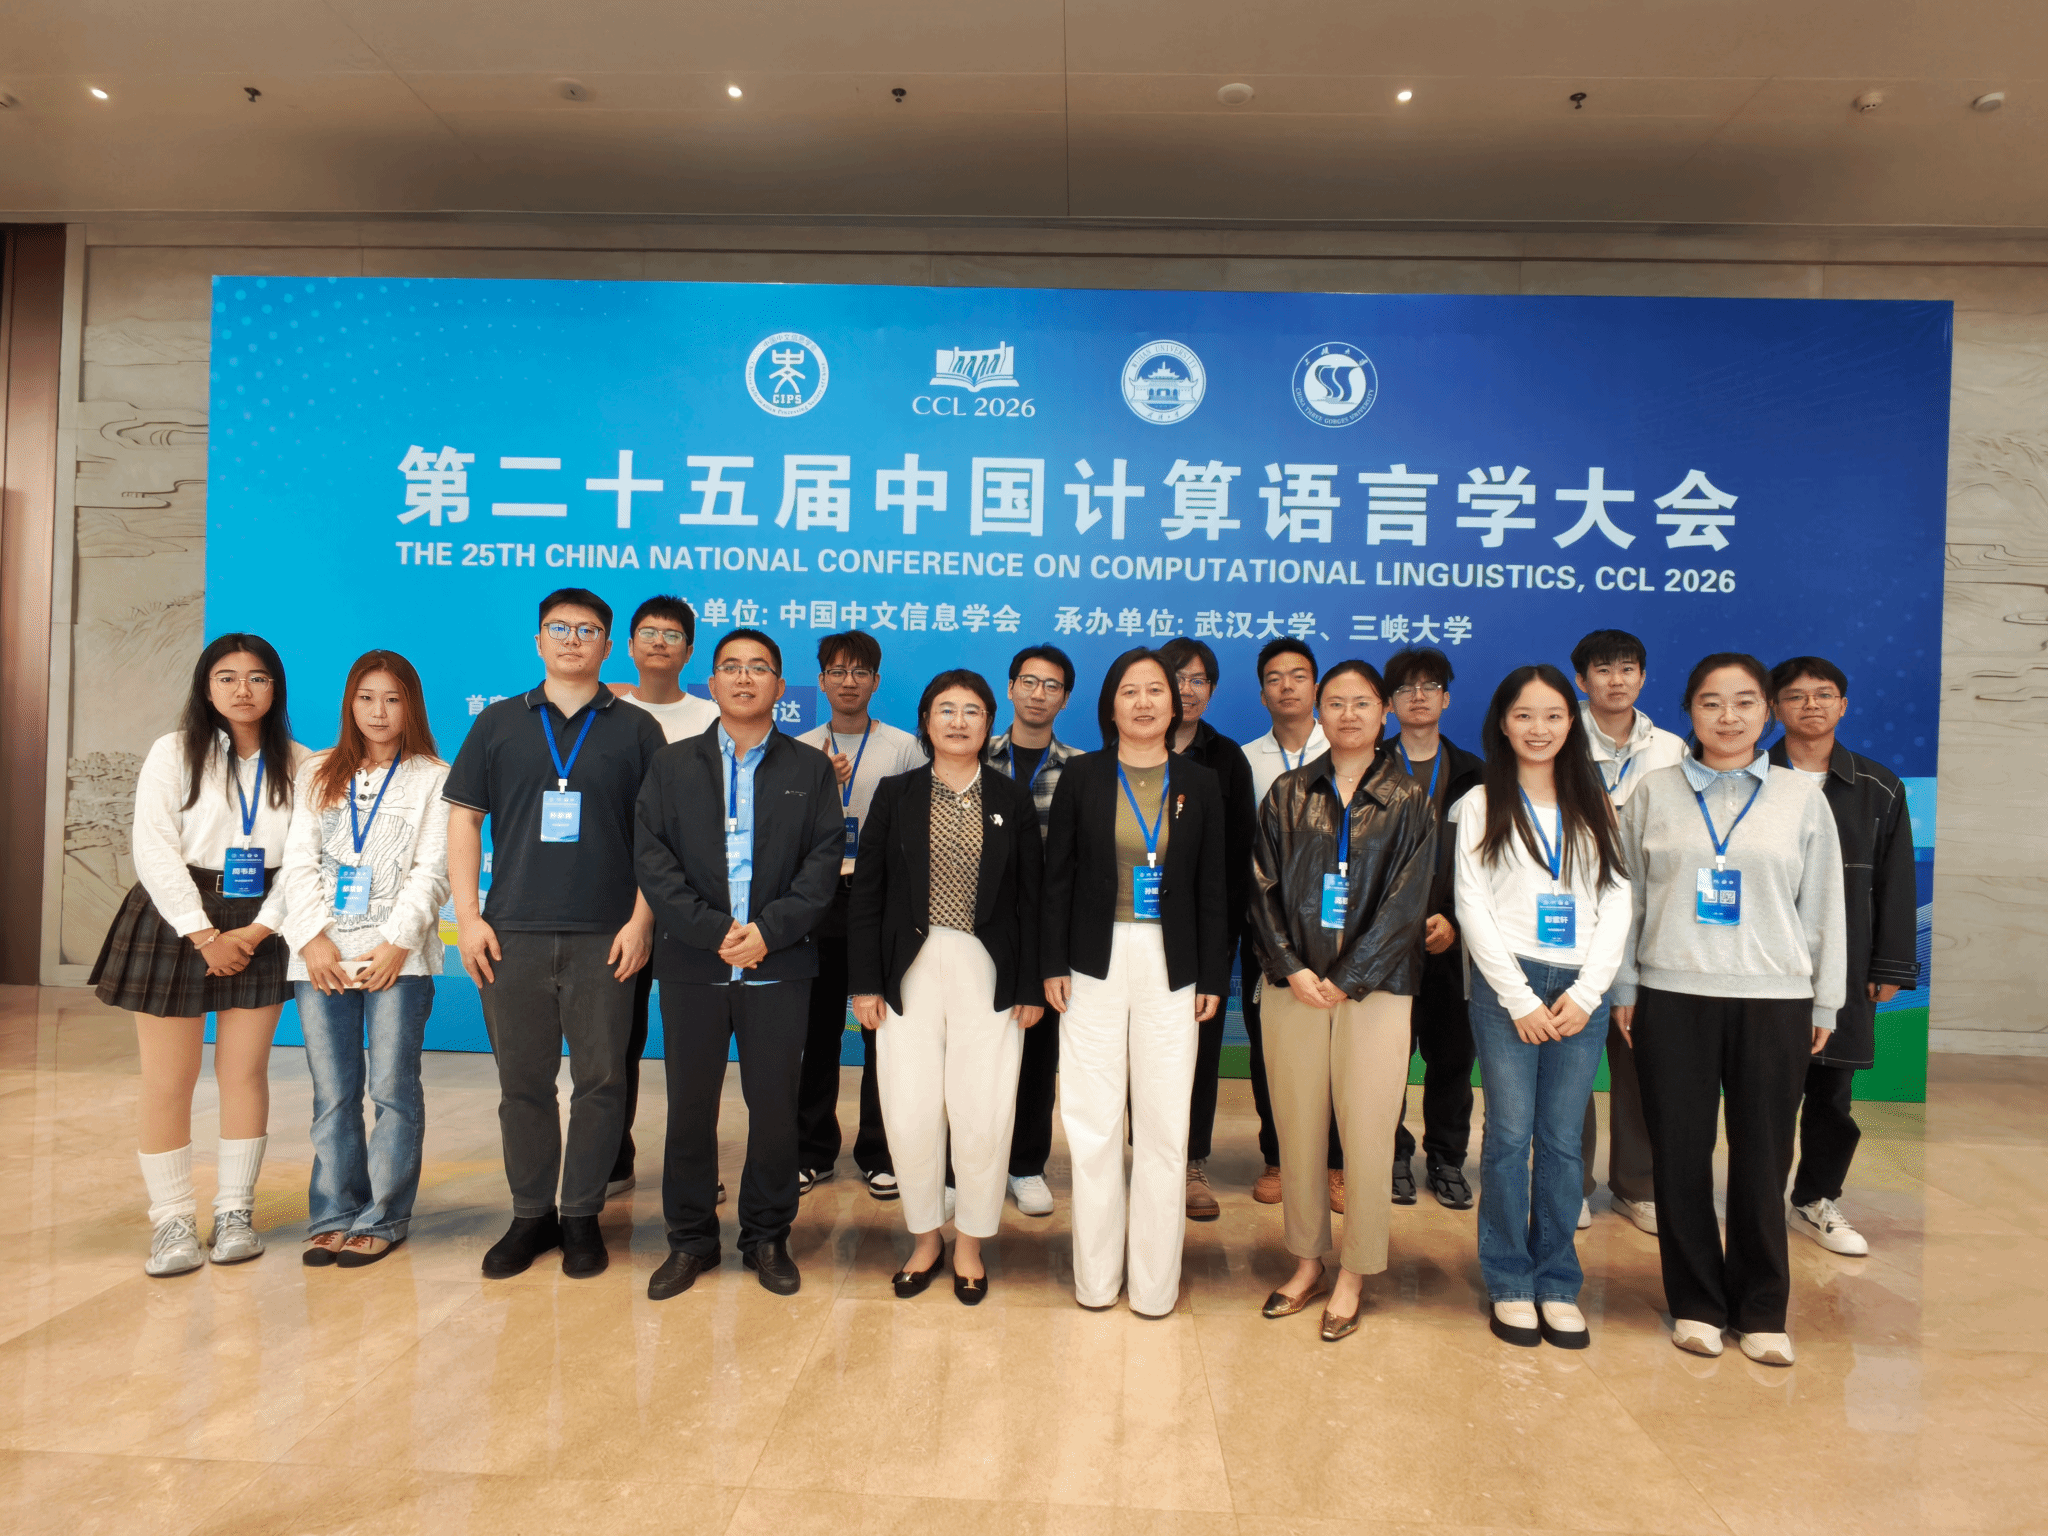
图1 中心教师及学生参加CCL 2026
中心共有9篇论文被大会接收,其中论文《中文网络文本意识形态风险识别研究》获评亮点海报论文。此次录用的研究成果涵盖大语言模型安全评测、意识形态风险识别、立场检测、知识掌握能力评测、古汉语智能处理、中文语法纠错和低资源民族语言处理等多个研究方向,体现了中心在自然语言处理与语言智能研究领域的持续探索。
被录用论文的简介如下:
1.中文网络文本意识形态风险识别研究(亮点海报论文)
作者:彭紫轩,陈波,孙京博,陈玉博,高歌,赵小兵
论文简介:
中文网络空间已成为公众表达观点和讨论社会议题的重要场域,涉及领土主权、民族关系等议题的文本中可能包含意识形态风险。然而,现有中文安全文本检测研究多关注冒犯性语言、有毒内容和仇恨言论,对意识形态风险的细粒度划分与系统评测仍显不足。针对这一问题,本文提出中文网络文本意识形态风险九分类任务,构建了包含1个安全类别和8个风险类别的标签体系,并建立了包含12,576条文本的中文数据集。在此基础上,选取涵盖传统机器学习、早期神经网络、预训练语言模型和大语言模型的11个模型开展系统评测。实验结果表明,经监督微调的BERT和RoBERTa整体表现最优,但模型在语义相近的风险类别之间仍容易发生混淆。该研究为中文网络文本意识形态风险的细粒度识别提供了数据基础,也为相关模型评测与错误分析提供了参考。
资源链接:https://github.com/Fuchsiaxuan/Ideological-Risk-Detection
2.形态先验驱动的低资源黏着语词表构建与语义初始化
英文标题:Morphology-Prior-Driven Vocabulary Construction and Semantic Initialization for Low-Resource Agglutinative Languages
作者:韩奥,张炜塬,胡家宇,孙媛
论文简介:
低资源黏着语在子词切分过程中容易出现跨越词干与后缀边界的问题,造成形态信息丢失;同时,词表扩展后新词嵌入的随机初始化或简单平均方式难以准确刻画形态组合语义。针对这些问题,本文提出一种形态先验驱动的两阶段词表构建与语义初始化框架。第一阶段在Morfessor形态切分语料上训练Unigram分词器,并通过后缀白名单与形态优先级筛选构建形态感知词表;第二阶段提出形态加权嵌入初始化方法,区分词干与后缀的不同作用,并引入已知词权重及范数校准机制。实验结果表明,该方法在蒙古语文本分类任务上取得82.76%的准确率,较BPE基线提升28.7个百分点,较Unigram基线提升4.6个百分点;在蒙古语—汉语翻译任务中,翻译质量与最强BPE基线相当,同时相较BPE-MeanInit平均推理时间降低31.9%。维吾尔语实验进一步表明,该方法在不同任务中的泛化效果存在差异。该研究为低资源黏着语适配大语言模型提供了一种低成本、无需任务特定形态标注的实用方案。
3.基于编辑级验证的中文语法纠错过纠抑制研究
作者:卫尧锐,陈波,赵小兵
论文简介:
大语言模型在中文语法纠错任务中展现出较强能力,但仍容易对原本可接受的表达进行不必要的修改,产生过度纠错问题。针对现有句子级提示方法难以精细控制多处修改的不足,本文提出一种基于编辑级验证的过纠抑制方法,将候选纠错生成与编辑验证相结合,实现对每处修改的独立判断。该方法首先通过字符级对齐抽取候选编辑,再结合原句、候选句及局部上下文,利用中文RoBERTa验证器对各项编辑进行评分,并通过阈值筛选决定修改的保留或回滚,无需调整基础纠错模型参数。实验结果表明,该方法能够在保留多数有效纠错、基本维持整体纠错性能的同时,减少不必要或错误的修改。进一步的人工评价与跨模型实验验证了其编辑筛选能力与适用性,为教学反馈等强调最小修改原则的中文语法纠错场景提供了细粒度、可调节的编辑控制方法。
4.最小事实前提对大语言模型能力的影响研究
作者:盛康,王淳昱,陈波,高歌,孙京博,陈玉博,赵小兵
论文简介:
大语言模型在知识密集型问答任务中的表现不仅依赖其生成能力,也高度取决于对关键事实的掌握与利用。现有研究多关注思维链推理与最终回答准确率,对模型回答错误的来源缺乏深入分析。针对这一问题,本文提出一种基于最小事实前提(Minimal Factual Premise,MFP)的知识掌握能力评测方法,通过显式提供支撑答案成立的关键事实,分析模型作答表现的变化。研究构建了最小事实前提数据集,并设计三种测试模式,对八个主流大语言模型在常识、事实和专业三类知识上的表现进行系统评测。实验结果表明,显式提供最小事实前提使模型回答准确率提升3.66个百分点,相较于链式推理提示,最小事实前提对比方法的正确率提升1.76个百分点。研究表明,可靠的事实知识是大语言模型完成知识密集型推理任务的重要基础,为模型知识掌握能力评测与错误归因分析提供了新的研究思路。
资源链接:https://github.com/mrblueskyyyy/MFP.git
5.Relation-Enhanced Multi-Target Stance Detection via Graph-LLM Collaborative Inference
作者:周韦彤,李澳华,陈波,高歌,孙京博,陈玉博,赵小兵
论文简介:
针对真实社交媒体中开放域多目标立场检测存在的目标间语义依赖利用不足、推理不一致及立场极性误判等问题,本文提出一种关系增强多目标推理框架REMIF。该框架首先识别并规范化文本中的显式与隐式目标,解析目标间的对比、一致、因果、层级、并列和类比关系,构建局部多关系图;随后利用关系图卷积网络传播拓扑信息,并将图结构转化为文本提示,引导大语言模型开展协同推理。实验结果表明,在中文社交媒体测试集的七个分层子集上,REMIF在匹配目标上的Macro-F1最高达到84.65%,优于文中采用的零样本提示、思维链提示及微调参考方法。消融实验进一步验证了关系解析、关系类型和图推理模块的有效性,表明显式建模目标间关系能够有效提升复杂语境下多目标立场判断的一致性与准确性。
6.基于大语言模型的《十三经》辞典释义自动生成研究
作者:曾庆炜,王思文,陈波,高歌,孙京博,陈玉博,赵小兵
论文简介:
传统古籍辞典释义编写高度依赖专家人工完成,存在文献阅读与校勘工作量大、编纂周期长以及难以规模化扩展等问题。针对这一现状,本文以儒家《十三经》词条为研究对象,探索大语言模型在古籍辞典释义自动生成任务中的应用。研究基于《十三经》多语言平行语料库构建释义生成数据集,设计六种提示模板,对WenyanGPT与GPT-4o开展对比实验。实验结果表明,大语言模型能够生成准确性和简明性较好的古籍词条释义。其中,融合角色设定、原典例句、词目类型提示和少样本示例的P6方案表现最佳,WenyanGPT的准确性评分达到4.18分,高于GPT-4o的3.74分。经人工校对后的200条样本与《十三经大辞典》核心义项的一致率达到92.5%。研究表明,大语言模型能够为古籍辞典编纂提供辅助,但仍需结合人工校对完善义项限定、文化信息补充和辞典体例规范,为数字人文领域古籍辞典的人机协同编纂提供了参考。
7.基于知识增强推理的足球社交领域立场检测
作者:牛子铭,陈波,高歌,孙京博,陈玉博,赵小兵
论文简介:
足球社交领域存在大量隐喻称谓、圈层话语和竞争性表达,给立场检测任务带来了目标实体不明确、立场判断不清晰等挑战。针对这一问题,本文提出足球社交领域开放目标立场检测任务,要求模型同时识别目标实体并判断其立场标签。研究构建了首个中文足球领域立场检测数据集Soccer-SD,包含125个主题和14,135条人工标注样例,并建立了融合领域隐喻映射与球迷关系图谱的领域知识库。在此基础上,提出一种知识增强推理方法,通过样本级背景知识匹配与四阶段结构化思维链推理,引导模型完成复杂语境下的综合判断。实验结果表明,通用大语言模型在缺乏领域知识时容易产生实体幻觉,而引入样本级背景知识能够提升目标实体识别能力,结构化思维链推理有助于改善复杂语境下的立场判断。该研究为垂直领域立场检测及领域知识增强的大语言模型推理提供了参考。
资源链接:https://github.com/niuziming7/FKER-Soccer-SD
8.基于细粒度数据增强的古汉语历史事件抽取方法
作者:宋瑞锦,申星恺,陈波,高歌,孙京博,陈玉博,赵小兵
论文简介:
古汉语历史事件抽取研究长期面临标注数据稀缺、语义表达高度凝练以及事件结构信息不足等挑战,尤其在细粒度事件论元抽取任务中,事件类型与论元角色存在明显的长尾分布问题。针对这些问题,本文构建了覆盖细粒度事件类型与论元结构的古汉语历史事件抽取数据集,并提出一种古汉语数据增强框架CCDA(Classical Chinese Data Augmentation)。该框架由事件样本增强模块(ESAM)和角色上下文补充模块(RCSM)组成,分别用于改善低频事件类型的数据分布和增强稀缺论元角色的表达能力。实验结果表明,该方法在事件检测、论元抽取和完整事件抽取任务上均取得性能提升,尤其在低频事件类型和稀有论元角色的识别方面改善更为明显。该研究为古汉语历史文献的结构化信息抽取与知识挖掘提供了新的技术思路。
资源链接:https://github.com/AfricanSSRJ/CCHEE
9.MetaSafe-ZH:面向中文大语言模型安全评测的文化隐喻表达数据集构建与分析
作者:谭煬煬,高歌,孙媛
论文简介:
近年来,大语言模型在安全对齐方面取得了显著进展,但其在中文高语境文化表达下的安全鲁棒性仍有待深入评估。针对这一问题,本文构建了面向中文大语言模型安全评测的文化隐喻表达数据集MetaSafe-ZH,包含3,364条有效评测样本,涵盖词汇隐喻、结构隐喻和混合隐喻三类表达形式。研究通过对16个主流大语言模型开展系统评测,并采用McNemar配对差异检验分析不同表达形式对模型安全表现的影响。实验结果表明,文化隐喻表达对应的越狱率整体高于纯文本基线,且结构层面的文化重构在平均越狱率增幅上高于单纯的词汇替换。该研究揭示了中文文化隐喻表达可能带来的模型安全风险,为大语言模型在复杂文化语境下的安全鲁棒性评测提供了数据资源和评测框架。